deepinfer是怎么运行的
一、什么是推理引擎
用户发送 AI 文字请求后,推理引擎负责拿到数据,并和模型数据一起放到 GPU 中,按照预定的计算方式算出结果。
目前优化很不错的推理引擎是 vLLM(参考 https://www.forasp.cn/html/3479.html )。vLLM 的核心贡献是把 KV Cache 管理、请求调度、前缀复用、分布式执行封装成一套高吞吐推理引擎,主要包括:
KV Cache:避免重复计算前文关系;
PagedAttention:用页表管理 KV Cache,消除内存空洞;
前缀共享与抢占:相同前缀只存一份;
连续批处理调度:让 GPU 少空闲;
Chunked Prefill:超长输入分段处理;
量化:降低显存门槛;
多卡与超大权重:专家权重按需加载、张量并行、流水线并行。
但 vLLM 有个问题:它适配了多种模型,没有针对性,适配的细节粗糙些。
二、DeepInfer 是什么
DeepInfer 是 DeepSeek 根据自己模型的特点以及最优计算方式方法,修改 vLLM 并借鉴了 SGLang、TensorRT-LLM 等开源引擎,得到的 DeepSeek 模型定制化引擎。
三、DeepInfer 的逻辑步骤
基本流程:
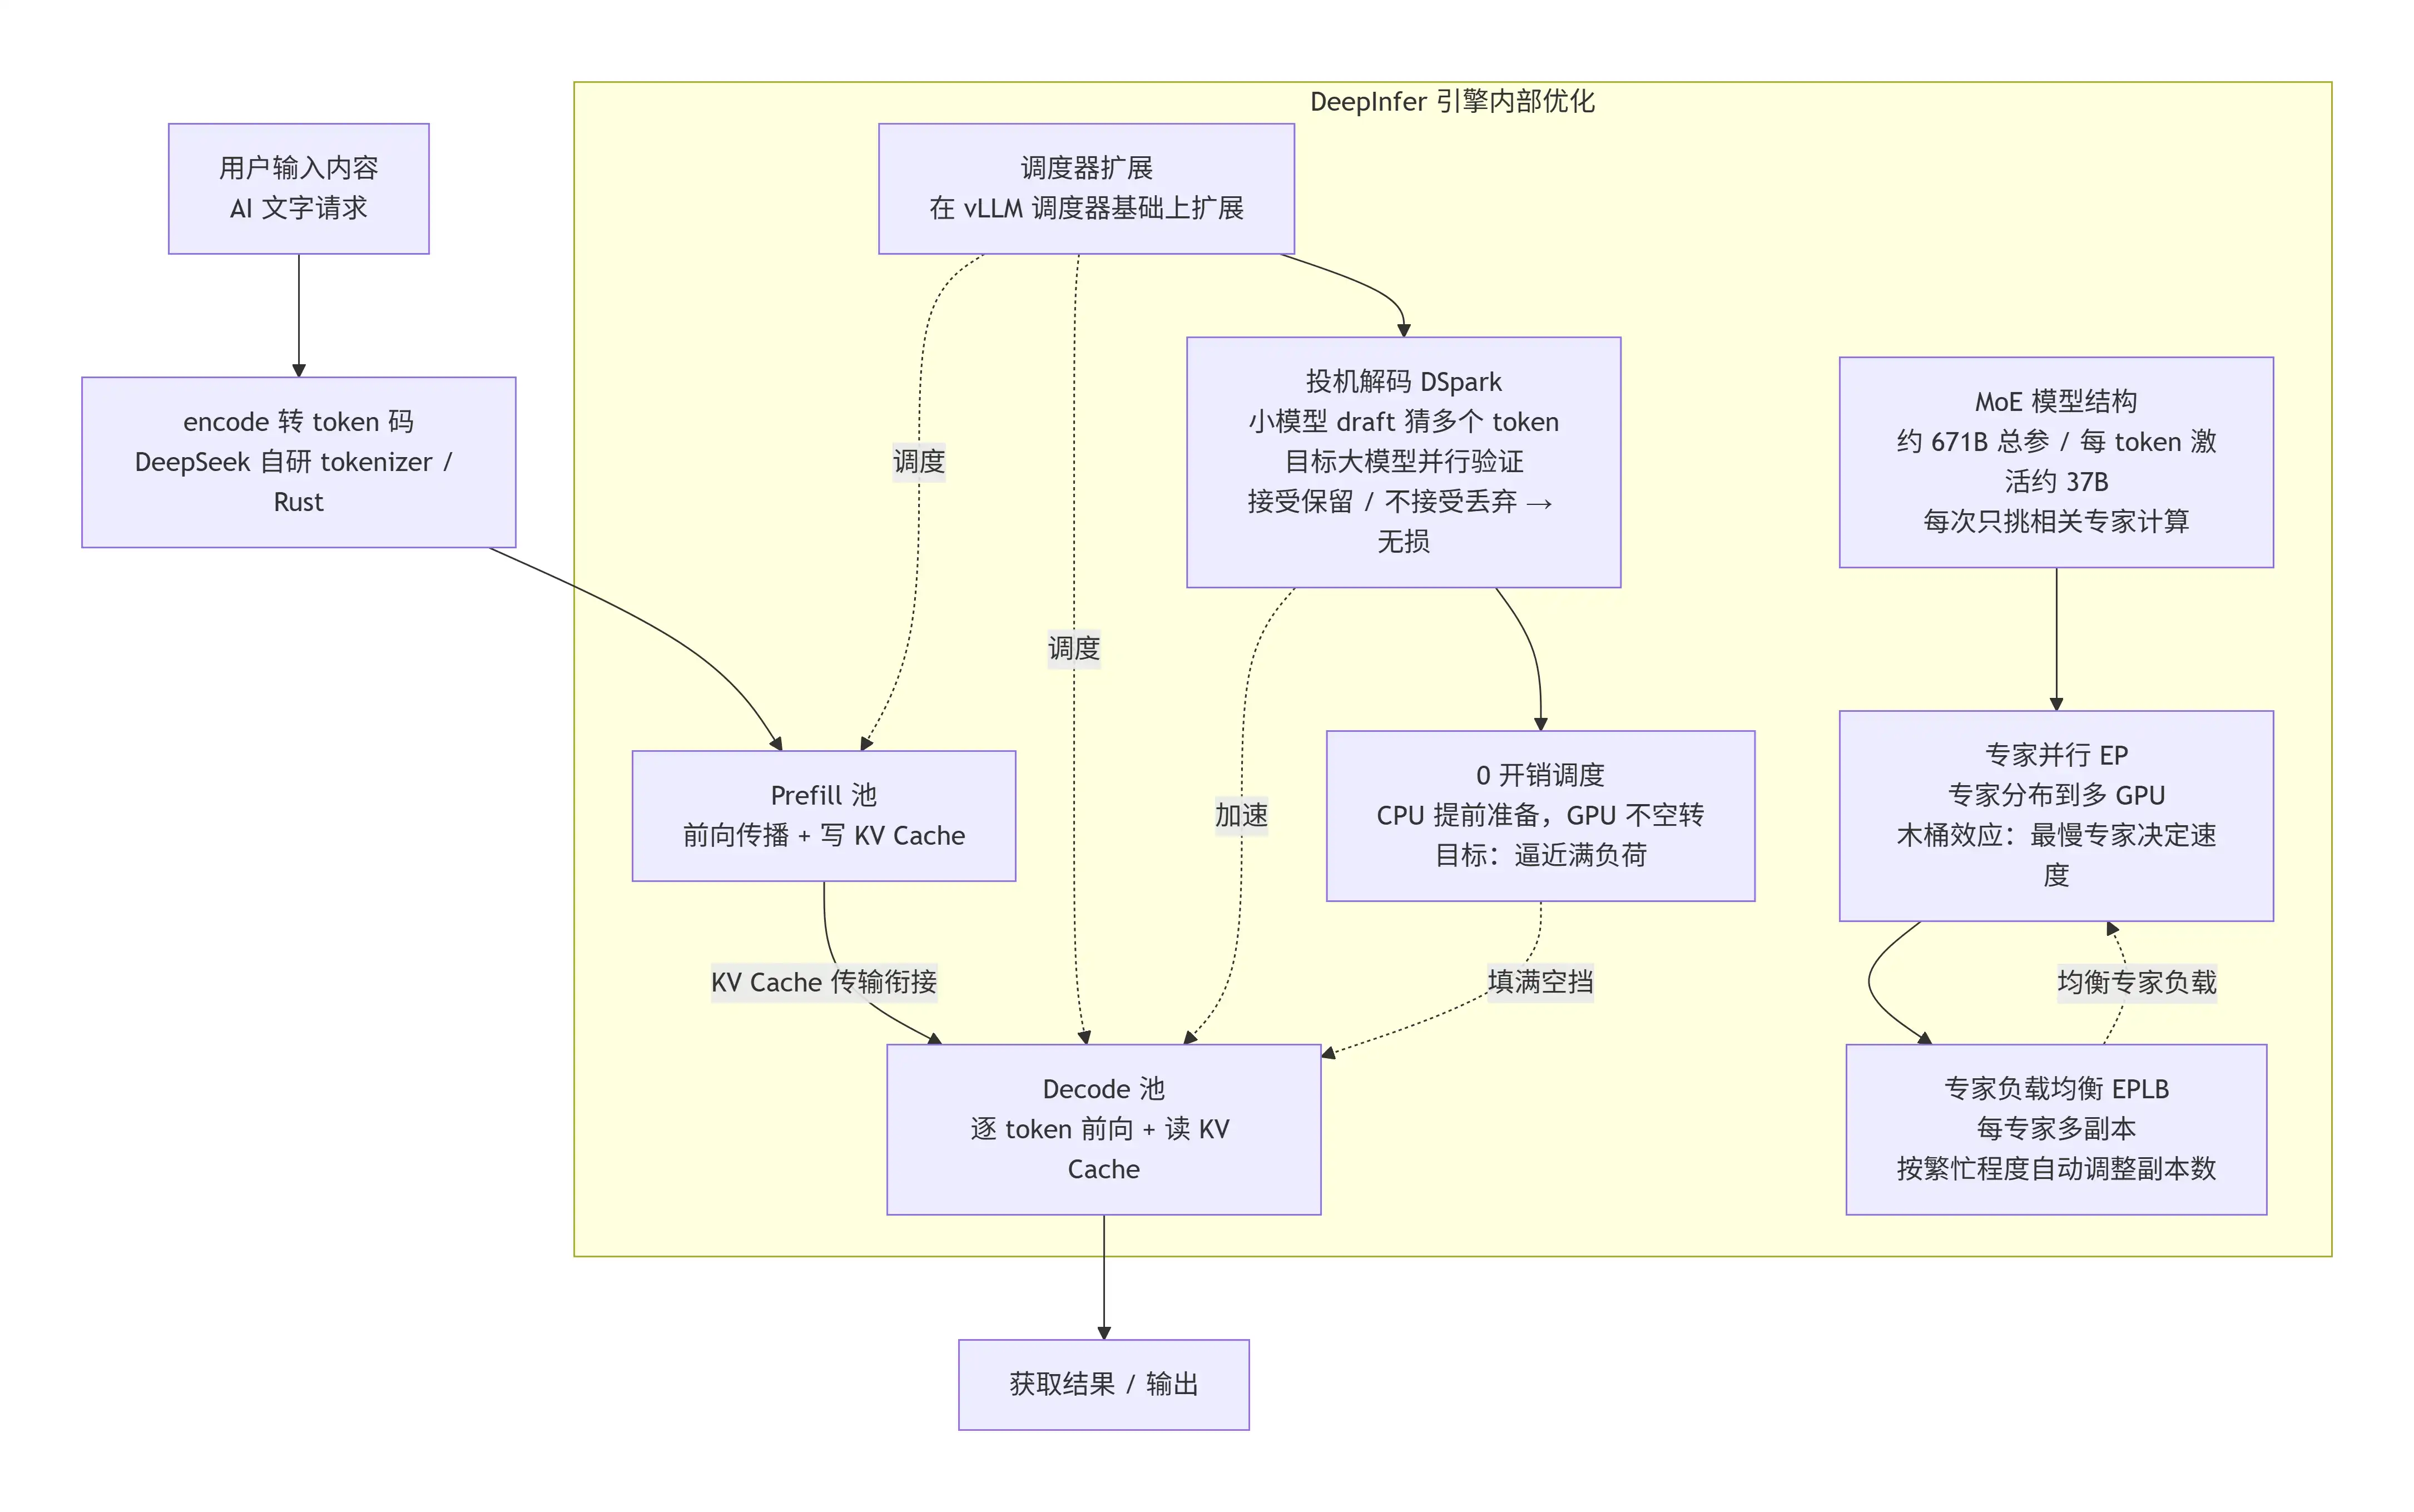
用户输入内容 → encode 转 token 码(DeepSeek 自研 tokenizer,Rust 实现)→ prefill(前向传播 + 写 KV Cache)→ decode(逐 token 前向 + 读 KV Cache)→ 获取结果
关键优化:
(1)Prefill / Decode 分离(阶段分离 + 流水线风格)
将 prefill 和 decode 分别用两个板块处理:原来一个硬件处理,现在改为顺承处理,更换为两个硬件处理——前一个叫 prefill 池,后一个叫 decode 池,二者通过 KV Cache 传输衔接,并非完全互不影响。
由于 decode 阶段每步每请求只生成 1 个 token,且是访存瓶颈(memory-bound),batch 增大时计算时间增加很少——算 1 个和算 10 个 GPU 计算时间基本一样。于是新增投机解码:让一个小模型(draft model)先猜出多个 token,再由目标大模型并行验证,不接受的直接丢弃、接受的部分保留,保证输出与大模型一致(无损)。实际业务中在 vLLM 调度器基础上扩展出调度器,计算各请求处理情况并合理安排调度,实现最有效率。整套方案也就是 DSpark(decode 吞吐提升 50%+)。
(2)0 开销调度
投机解码后 decode 变快,但 GPU 等硬件在多次处理中间仍有空挡时间,即 CPU 和 GPU 数据交换并获取下一步指令的时间。为了让 GPU 满负荷,让 CPU 提前准备好要处理的内容。这种方式叫0 开销调度,即调度本身不引入额外开销,目标是逼近硬件满负荷运转。
(3)MoE 模型结构与专家并行(EP)
DeepSeek 是超大型模型,约 671B 总参数,但每 token 仅激活约 37B,不用全部数据。模型层面通过拆分数据定义了小网络,每次只挑选相关的部分内容计算,这种挑选的每一个就是一个专家;每次运行使用不同的几个专家,它们组成了混合专家模型(MoE)。
因为专家数量多、单卡放不下,用专家并行(EP) 把不同专家分布到不同 GPU 上。专家并行拿到结果的最快时间取决于最慢的专家(木桶效应)。如果都用同一个专家就会卡顿,于是每个专家都多放几个副本,按照繁忙程度自动调整副本专家及数量,形成专家负载均衡(EPLB)。
四、整体组合
以上整体组合起来就是 DeepInfer:
基于 vLLM 修改 + 借鉴 SGLang / TensorRT-LLM → DeepSeek 定制化引擎
= Prefill/Decode 分离(双硬件池 + KV 传输)+ 投机解码(DSpark)+ 调度器扩展 + 0 开销调度 + MoE 模型 + 专家并行(EP)+ 专家负载均衡(EPLB)